
執筆者
K.S.
0情報同士の関係性を扱う仕組み
現在の生成AIブームを支えている技術の中心にあるのが、Transformer(トランスフォーマー)です。
ChatGPTをはじめとする大規模言語モデル(LLM)のほぼすべてが、このTransformerを基盤として構築されています。
しかしTransformerの革新性は、単に性能が高いということではありません。
その本質は、「情報そのものではなく、情報同士の関係性を扱う仕組み」にあります。
Transformer以前のAI
Transformerが登場する以前、文章を扱うAIの主流はRNN(Recurrent Neural Network)やLSTMでした。
これらのモデルは文章を読むとき、
『私 は 昨日 学校へ 行った』
というように、一語ずつ順番に処理していました。
人間が文章を読む感覚に近く見えますが、大きな問題がありました。
文章が長くなると、最初の情報を忘れてしまうのです。
例えば、
『昨日会った友人の妹が飼っている犬の名前はポチです。その犬は……』
という文章では、「その犬」が何を指しているかを理解するために、かなり前の情報を覚えていなければなりません。
RNN系のモデルは、このような長距離の関係を扱うことが苦手でした。
Transformerの発想
2017年、Googleの研究者たちは有名な論文
『"Attention Is All You Need"』
を発表しました。
この論文で提案されたのがTransformerです。
タイトルは直訳すると、
「必要なのはAttentionだけだ」
という意味になります。
ここでいうAttention(注意機構)こそがTransformerの核心です。
Attentionとは何か
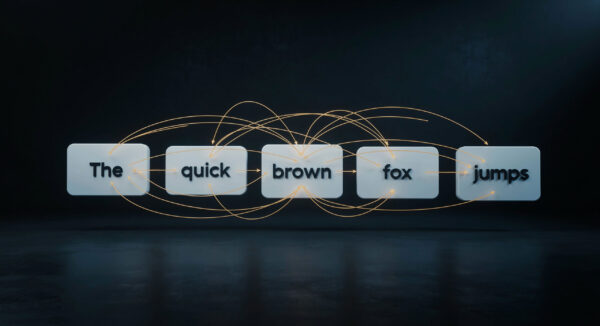
人間は文章を読むとき、すべての単語を均等に扱っているわけではありません。
例えば、
『猫がネズミを追いかけた。』
という文章では、「追いかけた」を理解するために、
・猫
・ネズミ
との関係を見ています。
一方、
『昨日の天気は晴れだった。』
なら、「晴れだった」と「天気」の関係が重要です。
つまり人間は、必要な情報に注意(Attention)を向けながら理解しています。
Transformerは、この仕組みを数学的に実装しました。
各単語が、「自分に関係がある単語はどれか」を計算しながら処理を行います。
関係性を学習する仕組み
従来のモデルは、
『単語 → 次の単語 → 次の単語』
という流れを重視していました。
Transformerは違います。
文章全体を一度に見て、「この単語とあの単語はどのくらい関係しているか」を計算します。
例えば、
『東京で生まれた彼は、現在大阪に住んでいる。』
という文では、「彼」と「住んでいる」が強く結びつきます。
また、「東京」と「生まれた」も関係しています。
Transformerは文章全体に対して、このような関係性の地図を作ります。
その結果、長い文章でも文脈を把握しやすくなりました。
Self-Attention
Transformerの中心技術はSelf-Attention(自己注意機構)です。
名前は難しそうですが、「単語同士が互いを参照する仕組み」と考えれば十分です。
文章中の各単語が、「自分にとって重要な他の単語は何か」を計算します。
例えば、
『太郎は学校へ行った。彼は勉強した。』
という文では、「彼」が「太郎」を強く参照します。
Self-Attentionによって、モデルは代名詞の指す対象や文脈上のつながりを理解できるようになりました。
なぜ性能が高いのか
Transformerが革命的だった理由の一つは、並列計算が可能だったことです。
RNNは順番に読む必要がありました。
しかしTransformerは文章全体を同時に処理できます。
そのためGPUとの相性が非常によく、
・より大きなモデル
・より大量のデータ
・より長い文章
を学習できるようになりました。
現在の数千億パラメータ級モデルが存在できるのも、この性質のおかげです。
ChatGPTとの関係
ChatGPTの「GPT」は、Generative Pre-trained Transformerの略です。
つまり、「Transformerを使った生成モデル」という意味です。
ChatGPTは大量の文章を学習し、次に来る単語を予測する訓練を繰り返しています。
例えば、
『日本の首都は』
という入力が来たら、「東京」という単語が続く確率を高く評価します。
これを何兆回も繰り返した結果、人間と自然に会話できるようになりました。
Transformerの本質
技術的な説明を離れると、Transformerの本質は非常に興味深いものです。
従来のAIは、「情報そのもの」を扱おうとしていました。
しかしTransformerは、「情報同士の関係性」を扱います。
これは人間の認知にも似ています。
私たちは単語を辞書的な意味だけで理解しているわけではありません。
文脈の中で、
・何と結びついているか
・何と対比されているか
・何を指しているか
によって意味を決定しています。
Transformerは、この関係性を大量の数値計算によって獲得する仕組みなのです。
知識ではなく構造を学ぶ
Transformerについて誤解されがちなのは、「大量の知識を覚えている」という理解です。
実際には、覚えているのは知識そのものというより、「世界の関係構造」です。
例えば、
・王と女王
・日本と東京
・フランスとパリ
といった対応関係。
あるいは、
・原因と結果
・質問と回答
・問題と解決策
といったパターン。
Transformerは膨大な文章から、こうした関係性のネットワークを学習しています。
だからこそ単なる暗記を超えて、新しい文章を生成できるのです。
おわりに
Transformerは単なるアルゴリズムではありません。
それは「知能とは何か」という問いに対する一つの答えです。
その発想は、世界を個々の情報の集まりとして見るのではなく、関係性のネットワークとして捉えることにあります。
人間の知性もまた、個別の事実の暗記ではなく、事実同士の結びつきを理解することによって成立しています。
Transformerは、その構造を数学的に実装した最初の大きな成功例でした。
現在の生成AI革命は、ある意味で「関係性を学ぶ機械」が実用化された結果だと言えるでしょう。
そして今後のAIの進化もまた、この関係性の理解をどこまで深められるかにかかっているのです。